Perplexity対策|2種類のクローラーと、Googleとの違い
「AIに勝手に使われている?」「robots.txtで止めるべき!」と迷っていませんか?
AIのクローラーはまとめて語られがちですが、目的も動き方も同じではありません。
この記事では、Perplexityの2種類のクローラーと、止める前の注意、書き方を解説します。
AI検索への対応を考えている方が、止めるか許可するかを目的から判断できるようになります。
Perplexityは答えと出典を同時に返す
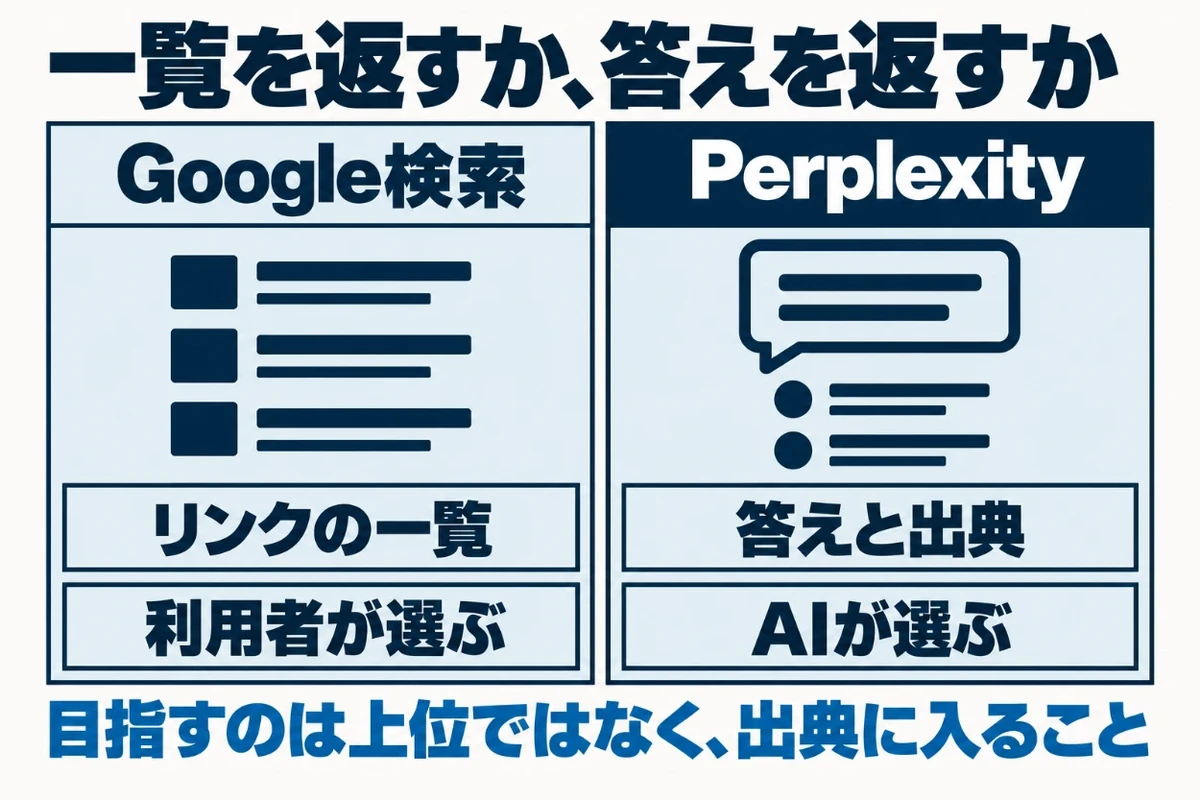
Perplexityは、質問に対して答えの文章と、根拠にしたサイトへのリンクを同時に返します。リンクの一覧を並べる検索結果とは、形が別物です。
この違いが、対策の前提になります。Google検索は上位を、Perplexityは出典に選ばれることを目指します。主な違いは次のとおりです。
| 比べる点 | Google検索 | Perplexity |
|---|---|---|
| 返すもの | リンクの一覧 | 答えの文章と出典のリンク |
| どのサイトを読むか | 利用者が一覧から選ぶ | AIが出典を選ぶ |
| 目指すこと | 上位に表示される | 出典に選ばれる |
出典の枠に入るかどうか
Perplexityの回答では、出典が番号付きで並びます。利用者が読むのは主に答えの文章で、リンクを開くのはその一部です。
出典に入らなければ、回答の中で名前が出ることもありません。2ページ目のような逃げ場がないため、入るか入らないかの差が大きくなります。だからこそ、クローラーに読まれる状態を保つことが出発点です。
選ぶのはAI
Google検索でクリックするページを選ぶのは、利用者です。Perplexityでは、どのサイトを根拠にするかをAIが先に決めます。
そのため、目を引くタイトルより、答えの材料として抜き出しやすい形が効きます。見出しの直後に結論があり、根拠が添えられている文章です。書き方の工夫は、Google検索のAIによる概要でも同じように役立ちます。
Perplexityの2種類のクローラー
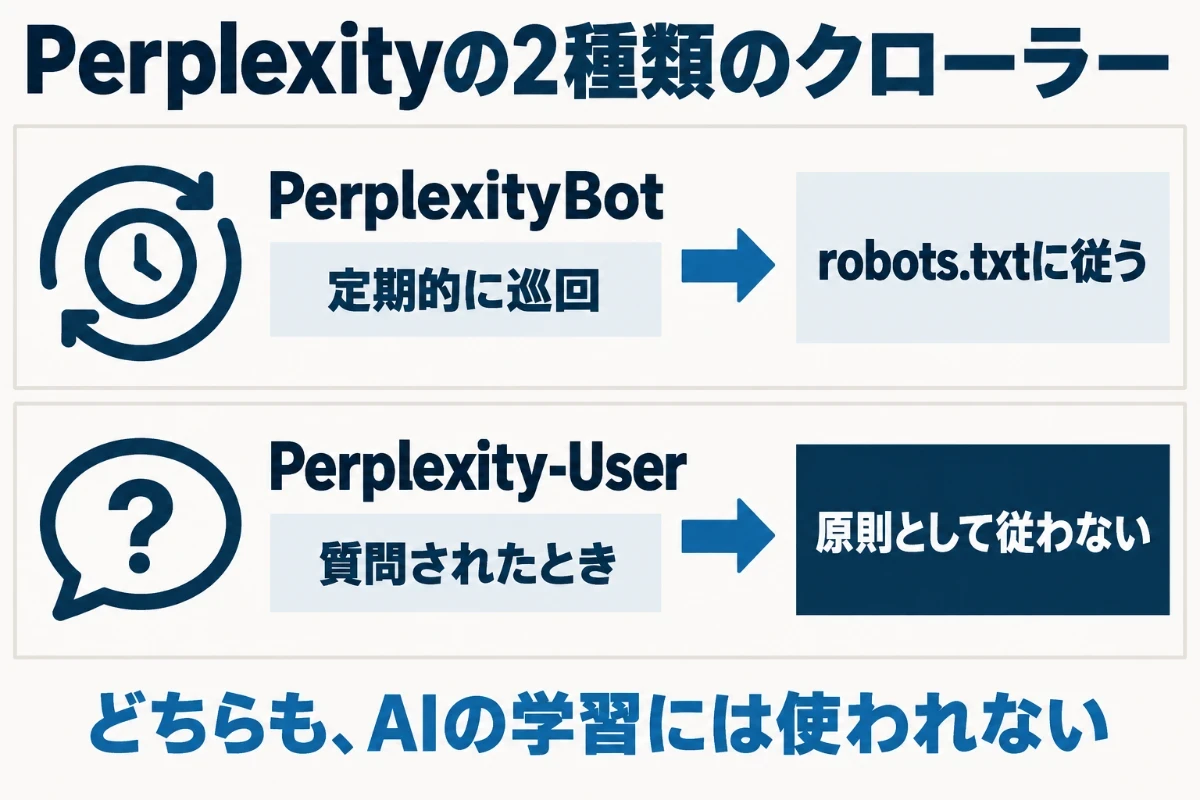
Perplexityは、2つのクローラーを使い分けています。役目の違いは、公式の説明に分けて書かれているとおりです。
どちらも、AIの基盤モデルの学習に使うためのものではないと説明されています。学習に使われたくないという理由だけなら、Perplexityを止める理由にはなりません。違いは、動くきっかけとrobots.txtの扱いにあります。
① PerplexityBotは検索結果のために巡回する
PerplexityBotは、検索結果にサイトを出してリンクするためのクローラーです。サイトをあらかじめ巡回して、回答に使える状態にしておきます。
検索結果に出たいなら、PerplexityBotを許可するよう公式は案内しています。拒否すれば、出典の候補から外れるのは避けられません。robots.txtを変えてから反映されるまで、24時間ほどかかるとされています。
② Perplexity-Userは質問されたときに動く
Perplexity-Userは、質問を受けたときにその場でページを取りに来ます。事前に巡回するのではなく、必要になった瞬間に動く仕組みです。
利用者の求めで取りに行くため、robots.txtは原則として無視すると公式に書かれています。robots.txtでPerplexity-Userを拒否しても、止まるとは限りません。2つを同じものとして扱うと、設定が意図どおりに効きません。
robots.txtでPerplexityを止める前に
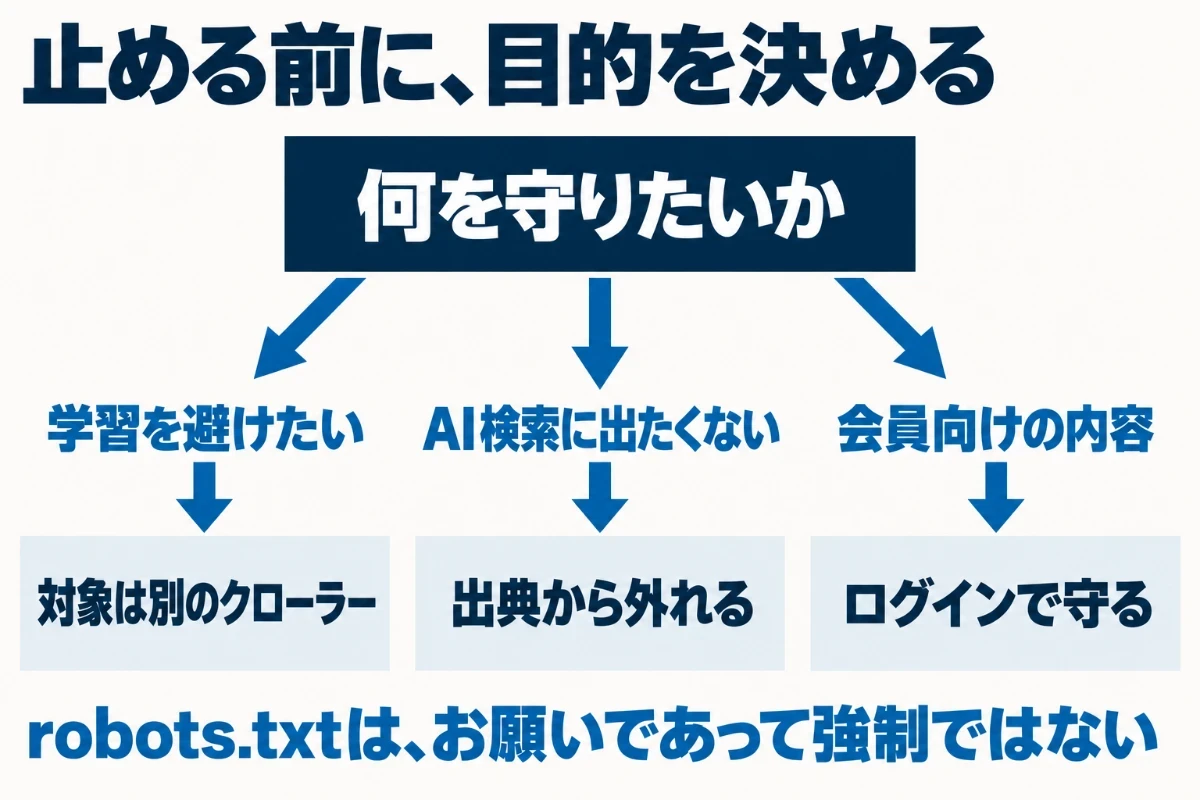
拒否の設定を書く前に、何を止めたいのかを決めます。目的によって、対象にすべきクローラーも手段も変わります。
AIの学習に使われたくないのか、AI検索に出たくないのか。この2つは別の話として扱います。学習を避けたいなら、対象は学習用のクローラーで、Perplexityの2つではありません。目的が決まらないうちは、設定を変えずにおくのが安全です。
止めると、出典から外れる
PerplexityBotを拒否すると、回答の出典から外れていきます。そこから来ていた訪問者がいなくなるのも当然です。
記事を読んでもらうために書いているなら、拒否は目的と逆に働きます。拒否を考えるのは、有料の内容や会員向けのページを守りたい場合に限られます。迷っているなら、許可したままで困ることはほとんどありません。
robots.txtは強制ではない
robots.txtは、クローラーへのお願いです。従うかどうかは、それぞれのクローラーの作りに任されています。
2025年8月、Cloudflareが「拒否の設定が回避されている」と指摘しました。Perplexity側は、これに反論しています。どちらの言い分が正しいかに関わらず、確実に守りたい情報はrobots.txtに頼らないでください。ログインやパスワードなど、ページ側の仕組みで守ります。
当サイトのrobots.txt
当サイトのrobots.txtは、管理画面を除外し、サイトマップの場所を示すだけです。AIのクローラーを個別には指定していません。
User-agent: *
Disallow: /wp-admin/
Allow: /wp-admin/admin-ajax.php

Sitemap: https://infosuccess.jp/wp-sitemap.xml
AI検索の対策を扱うサイトで、AIに読まれない設定にする理由がないためです。何を守りたいかが決まっていないなら、既定のままで構いません。
Perplexityに引用されやすくする3つの書き方
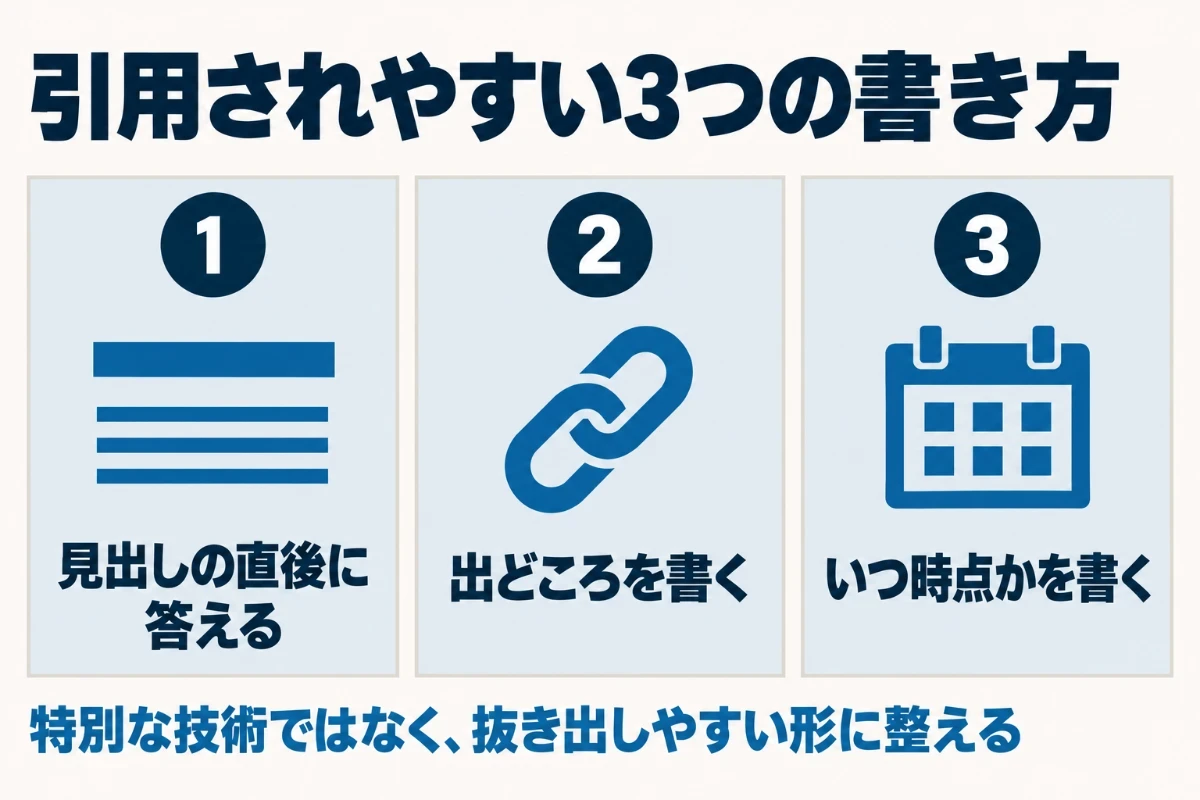
出典に入るための作業は、特別な技術ではありません。答えとして使いやすい形に整えることです。見出しの立て方と、段落の書き方を少し変えるだけです。
AIは記事の一部を抜き出して、回答を組み立てます。内容が同じでも、どこを抜き出せばいいかが分かる形かどうかで差が出ます。次の3つは、Google検索やChatGPTの検索にも共通する書き方です。
① 見出しの直後に答える
見出しのすぐ下に置くのは、その見出しの結論です。前置きや背景を先に置くと、抜き出せる部分が後ろにずれます。
当サイトの記事も、各h2の最初の段落に答えを置き、理由や補足はそのあとに続ける形です。1つの段落で話が完結していると、そこだけを抜き出しても意味が通ります。ほかの段落を読んでいないと分からない書き方は避けてください。
② 出どころを書く
数字や仕様を書くときは、どこの情報かを明記します。公式の説明、公的な調査、自社での実測のどれかです。
出どころが書かれていれば、根拠として扱いやすくなります。逆に、出どころのない数字は、読み手にとっても確かめようがありません。断定するほど、根拠を添える必要があります。参考にした公式のページには、リンクを置いておきます。
③ いつ時点の情報かを書く
仕様が変わりやすい分野では、いつ時点の情報かを書くのが基本です。「2026年10月時点」と添えるだけで、情報の鮮度が伝わります。
AI検索の分野は、数か月で仕様が変わることがあります。古い情報のまま残っている記事は、読み手を誤らせる原因にもなりかねません。内容を直したら、更新した日も記事に示しておきます。古い記事を見つけたら、日付と中身を一緒に直してください。
Perplexityでの表示を確かめる方法
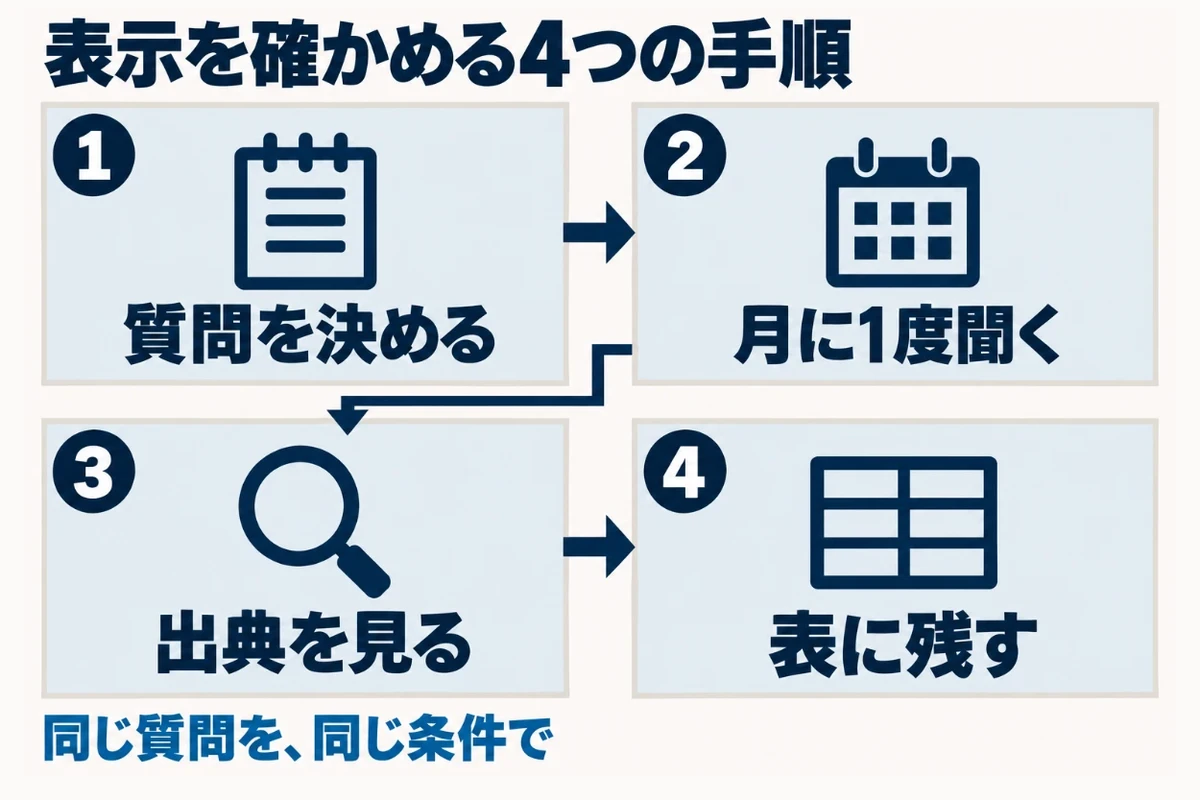
Perplexityでの引用の状況を見る、運営者向けの画面はありません(2026年10月時点)。自分で質問して確かめるのが確実です。手間はかかりますが、実際の回答を見るのがいちばん確かです。
毎月続ける作業になるため、質問の数は5つほどに絞ります。増やしすぎると、続けるのが難しくなるためです。結果は表に残し、記事を直した日と並べて見ます。
質問を決めて、月に1度聞く
手順は次の4つです。毎回同じ条件で行うことが大切です。
- 自社のサービスに関わる質問を5つ書き出す
- Perplexityで、同じ文のまま聞く
- 回答の出典に、自社のサイトが入っているかを見る
- 日付と結果を、表に残す
ログインの有無や端末で、結果が変わることがあります。そろえておかないと、変化が記事を直した効果なのか分かりません。
アクセス解析で参照元を見る
Googleアナリティクスなどでは、Perplexityからの訪問を参照元で見られることがあります。参照元に「perplexity」を含む行を探してください。
数は多くないことが一般的です。流入の数で判断するより、出典に入っているかどうかを見るほうが実際的です。どのページに来ているかが分かれば、引用されやすい書き方のお手本にもなります。
Perplexity対策に関するよくある質問
Perplexityは拒否したほうがいいですか
記事を読んでもらいたいなら、許可したままで構いません。拒否すると、回答の出典から外れ、そこからの訪問者もいなくなります。
拒否を考えるのは、有料の内容や会員向けのページを守りたい場合です。その場合も、robots.txtだけでは確実に止まりません。ログインなど、ページ側の仕組みとあわせて守ってください。
ChatGPTやGoogleとは、対策が違いますか
書き方の対策は共通です。見出しの直後に答える、出どころを書く、日付を書く。この3つは、どのAI検索にも効きます。
違うのは、クローラーの名前と、robots.txtの書き方です。それぞれの会社が公式にクローラーの一覧を出しているため、設定するときは一覧で名前を確かめてください。1社ずつ別の対策を用意する必要はありません。
robots.txtで拒否すれば、確実に止まりますか
止まるとは限りません。robots.txtはお願いであって、強制する仕組みではないためです。
Perplexity-Userは、robots.txtを原則として無視すると公式にあります。確実に守りたい情報は、ログインやパスワードで保護してください。公開しているページは、読まれる前提で書くのが現実的です。
Perplexityは、記事をAIの学習に使いますか
公式の説明では、2つのクローラーとも、AIの基盤モデルの学習には使わないとされています。目的は、回答を作ることと検索結果に出すことです。
学習に使われたくない場合は、学習用のクローラーを出しているほかの会社の設定を見直します。名前と役目は各社の公式の一覧で確かめてください。Perplexityを止めても、学習への対策にはなりません。
Perplexityに出るまで、どれくらいかかりますか
決まった期間はありません。PerplexityBotがページを読み、質問に合う内容だと判断されて初めて出典に入ります。
新しい記事で先に必要なのは、検索エンジンに見つけてもらう状態です。サイトマップを用意し、ほかの記事から内部リンクを張っておきます。そのうえで月に1度質問して、出典に入ったかを記録してください。
まとめ
Perplexityは、答えと出典を同時に返す仕組みです。Google検索の上位表示とは別に、出典に選ばれるかどうかが問われます。
クローラーは2種類あります。robots.txtに従うのはPerplexityBotで、もう一方は原則として従いません。どちらも学習には使われないため、学習を避けたいだけなら止める理由になりません。書き方は、見出しの直後に答え、出どころと日付を書くことが基本です。
まずは自社に関わる質問を1つ選び、Perplexityで聞いて出典を確かめてください。