AIクローラーを拒否すべきか|robots.txtでブロックする判断と失うもの
「AIに勝手に学習されたくない」「GPTBotは止めたほうがいいと聞いた!」と迷っていませんか?
1行足すだけの作業に見えて、書き方によってはAI検索から自社が消えることもあるのです。
この記事では、学習用と回答用の違いと、4社のクローラー名、止めると失うもの、止め方の判断を解説します。
AI検索への対応を考えている方が、自社の方針を決められるようになります。
AIクローラーは、学習用と回答用で分かれている
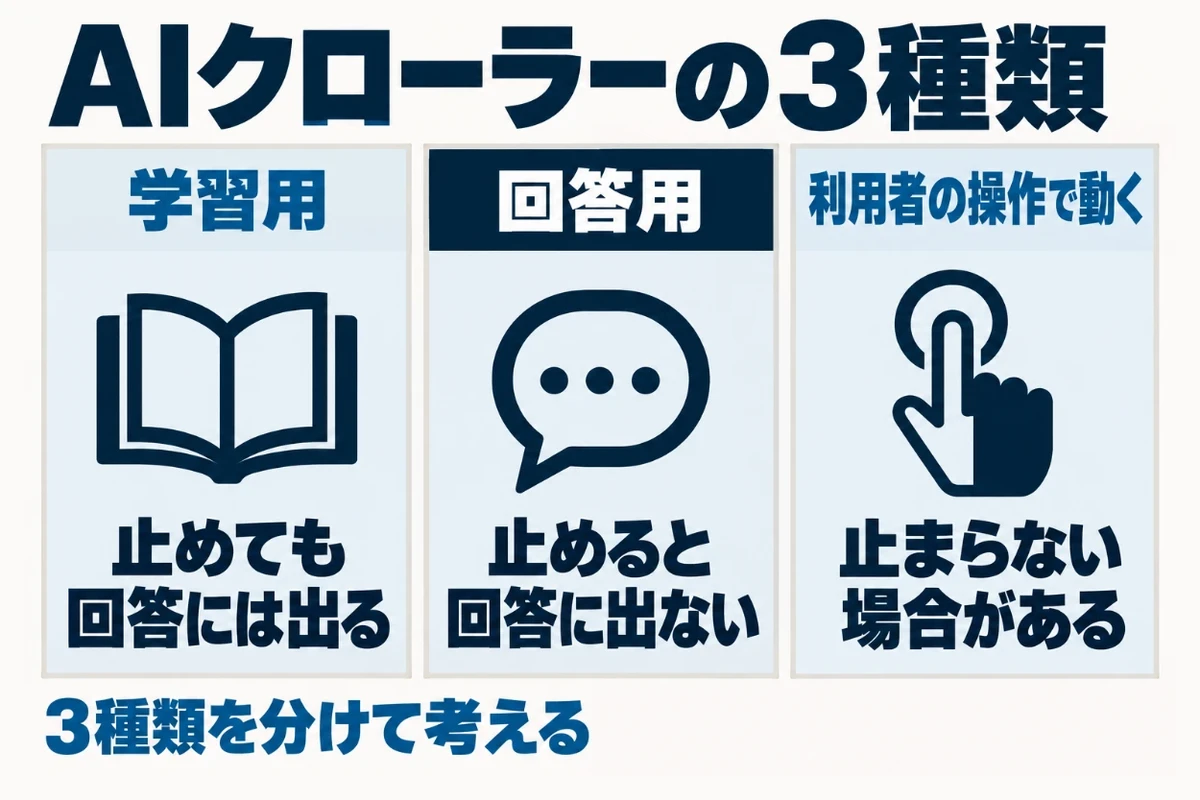
AIクローラーをひとまとめに考えるのは、判断を誤るもとです。各社とも、用途ごとに別の名前を用意しています。
robots.txtでの指定も、名前ごとに独立しています。どれを止めるかで、失うものがまったく違うのです。3つの種類の違いは次のとおりです。
| 種類 | 役目 | 止めると |
|---|---|---|
| 学習用 | AIの学習に使う内容を集める | 学習に使われにくくなる |
| 回答用 | AI検索の回答に出す索引を作る | そのAIの回答に出なくなる |
| 利用者の操作で動くもの | 質問されたときに取りに来る | 止まらない場合がある |
学習に使うもの
AIのモデルを学習させるために、内容を集めるクローラーです。これを拒否すると、学習に使わないでほしいという意思表示になります。
ここを止めても、AI検索の回答に出るかどうかには影響しません。学習と回答は、別の仕組みで動いているためです。学習だけを嫌うなら、このクローラーだけを止めれば足ります。止める前に、自社の記事が学習に使われて困る理由を書き出してみてください。
回答に使うもの
AIが回答を作るときに参照する、索引を作るためのクローラーです。ここを拒否すると、そのAIの回答に自社のページが出てこなくなります。
集客のためにAI検索へ対応したいなら、止めてはいけないのがこちらです。学習を嫌ってまとめて拒否すると、ここまで一緒に閉じてしまいます。名前を1つずつ確かめてから書いてください。
利用者の操作で動くもの
利用者がAIに質問したとき、その場でページを見に来る取得です。自動で巡回するのではなく、人の操作がきっかけになります。人が見ているページを、AIが代わりに読みに行くイメージです。
この種類は扱いが特殊で、robots.txtの指定が適用されない場合があります。各社がそう説明しているため、止める前提で考えないほうが安全です。止めたい内容がある場合は、ページ側の保護を考えます。
主な4社のAIクローラーの名前
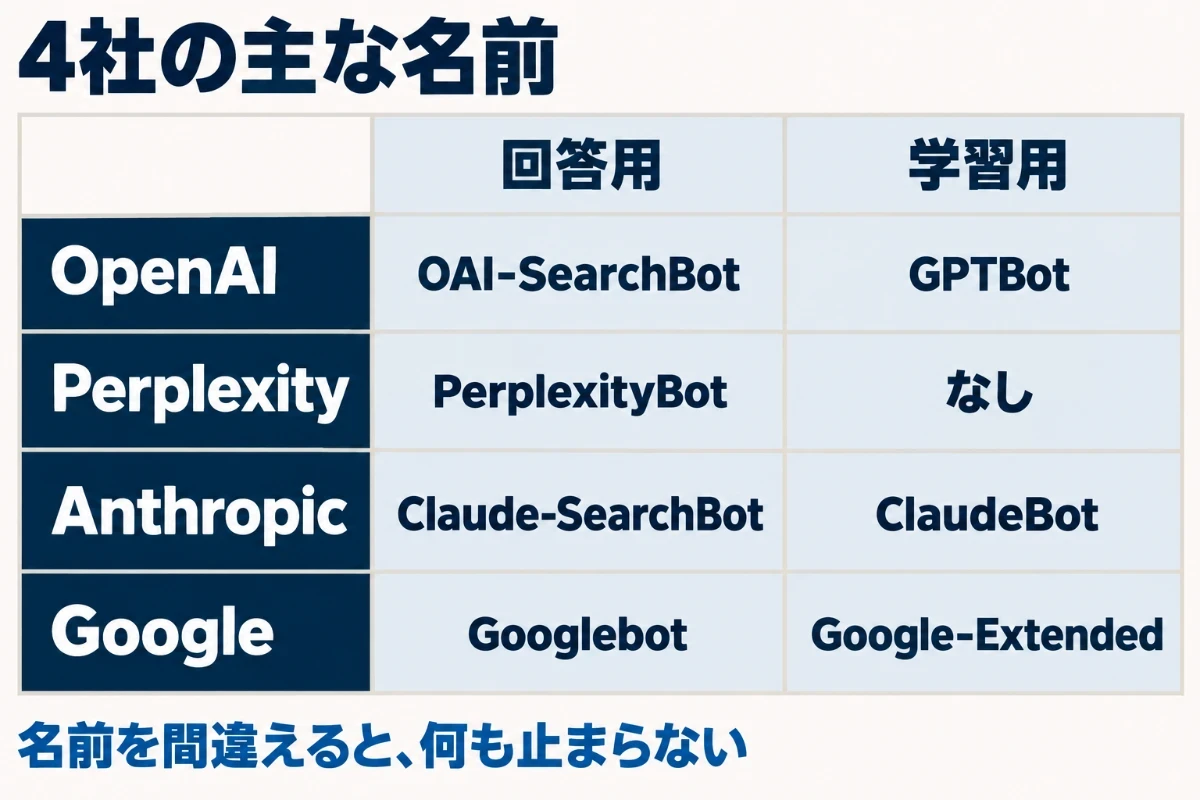
robots.txtは、サイトの直下に置く文字だけのファイルです。User-agentの行でクローラーの名前を指定し、続くDisallowの行で止める範囲を書きます。
名前を1文字でも間違えると、何も止まりません。主な4社の名前を、公式の説明にもとづいて整理します。設定するときは、各社の最新の一覧も確かめてください。
① OpenAI
公式の説明では、検索に出すためのものがOAI-SearchBot、学習用がGPTBotです。2つは独立した設定です。検索用を許可したまま、学習用だけを拒否する例も公式に挙げられています。
ほかに、利用者の操作で動くChatGPT-Userもあります。検索用を拒否したサイトは、ChatGPTの検索の回答に出なくなる仕組みです。ただし、案内のリンクとしては出る場合もあると説明されています。
② Perplexity
PerplexityBotは、Perplexityの検索結果に出すためのクローラーです。公式には、AIの基盤モデルの学習には使わないと明記されています。
つまり、PerplexityBotを拒否しても、学習を止める効果はありません。利用者の操作で動くPerplexity-Userも、学習には使われないとされています。止めるとPerplexityの回答から外れるだけだと考えてください。
③ Anthropic
Anthropicは、3つの名前に分けています。それぞれの役目は次のとおりです。
- 学習用:ClaudeBot
- 利用者の操作で動くもの:Claude-User
- 検索のための索引づくり:Claude-SearchBot
Claude-SearchBotを止めると、検索結果での見え方が下がる可能性があるそうです。学習だけを止めたいなら、ClaudeBotだけを拒否する形になります。
④ Google
Googleは、仕組みが違います。学習の管理には、Google-Extendedというトークンを使います。専用のクローラーがあるわけではなく、robots.txtで意思を示すための名前です。
Google-Extendedは、検索での登録や順位に影響しないと公式に明記されています。対象になるのは、Geminiのモデルの学習と、回答の根拠づけへの利用です。Googlebotを止めると検索そのものから消えるため、混同しないでください。
AIクローラーを止めると何が起きるか
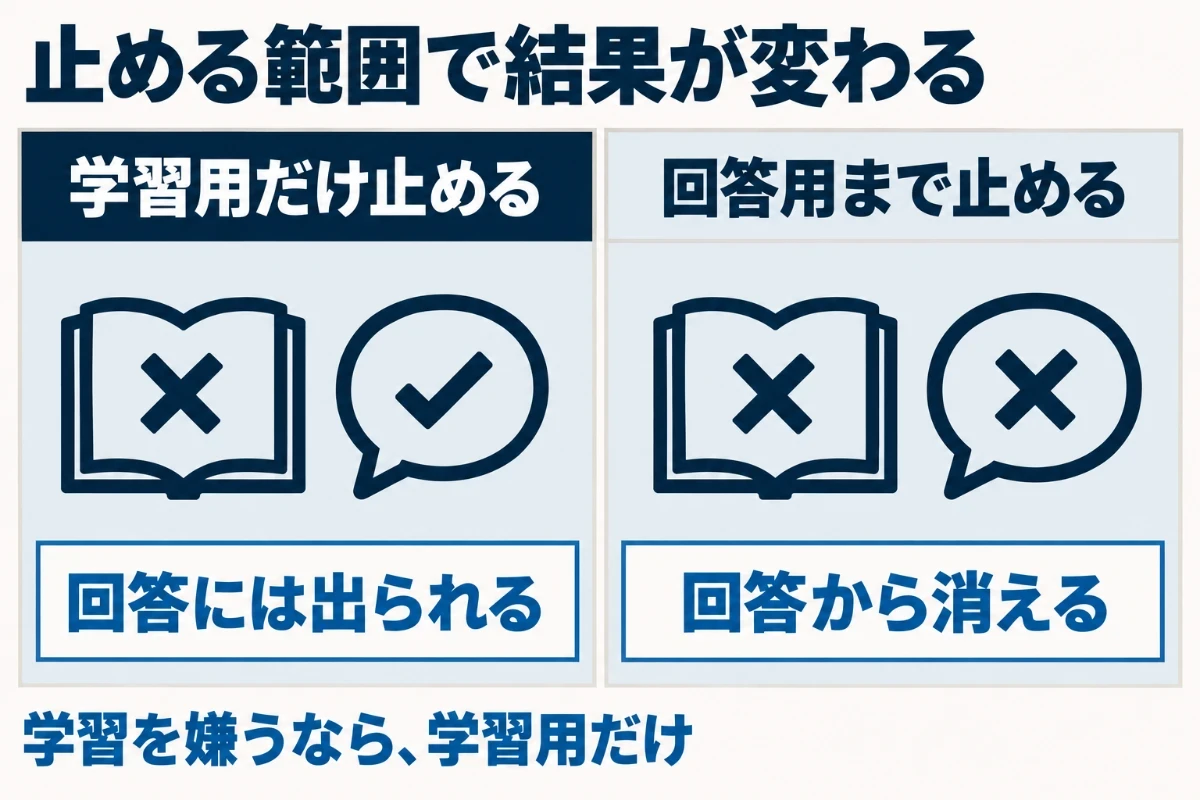
まとめて拒否する前に、何を得て何を失うかを分けて考えます。目的が学習の拒否なのか、AI検索に出ないことなのかで、書く行が変わります。
多くの会社にとっての答えは、学習用だけを止めるか、何も止めないかのどちらかです。回答用まで止める理由がある会社は、そう多くありません。迷ったら、何も止めない状態から始めてください。
学習だけを止める書き方
学習用だけを拒否すれば、AI検索の回答に出る余地は残ります。たとえばOpenAIとGoogleの学習だけを止めるなら、次のように書きます。
User-agent: GPTBot
Disallow: /

User-agent: Google-Extended
Disallow: /学習に使われることへの抵抗と、AIを通じて見つけてもらいたい気持ちは、両立させられるのが利点です。なお、OpenAIは両方を許可しているサイトについて説明しています。重い巡回を避けるため、片方の結果を両方の用途に使うことがあるそうです。
回答用を止めると、回答に出なくなる
回答用を拒否すると、そのAIの回答には出てこなくなります。集客のためにサイトを運営しているなら、自分から窓口を閉じるのに近い判断です。
学習を止めたいだけなら、対象を絞ってください。数年前のテンプレートをそのまま使うと、止めるべきでない名前まで入っていることがあります。書いた行が、学習用と回答用のどちらかを1つずつ確かめます。
robots.txtでは止まらないAIクローラーがある
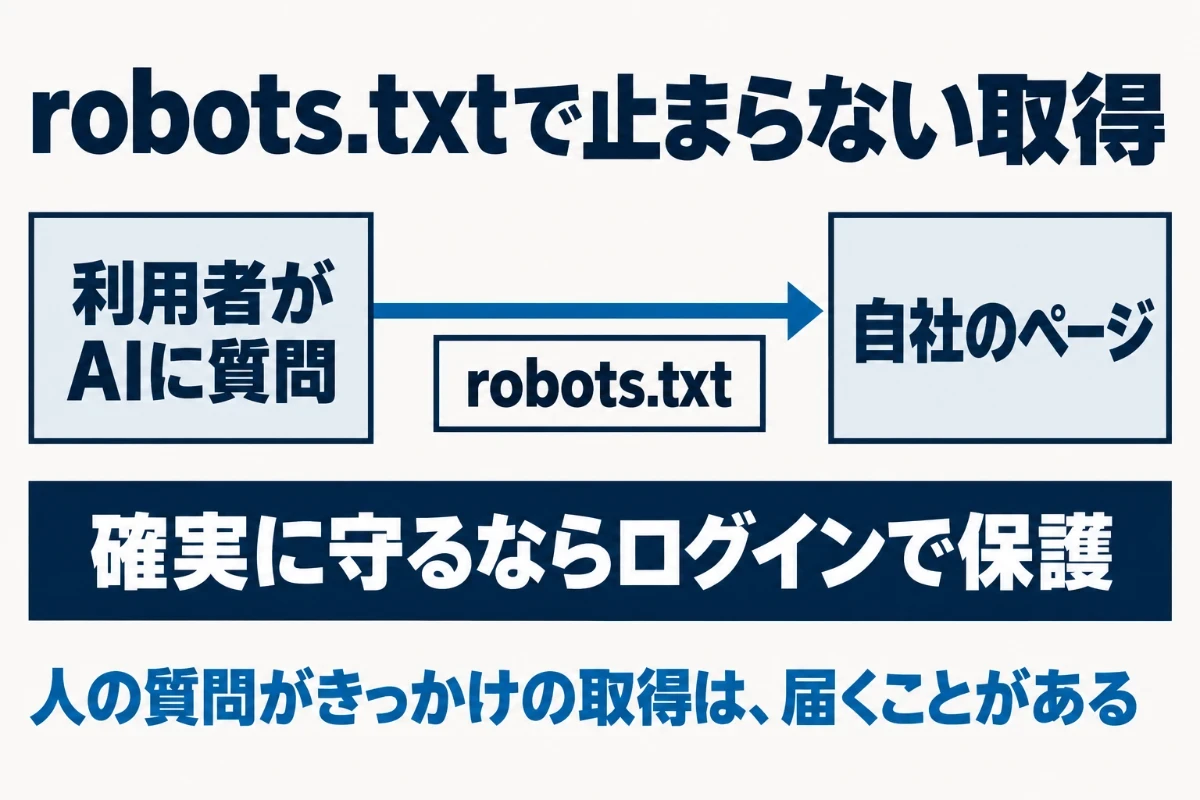
ここが見落とされがちな部分です。robots.txtに書けばすべて止まる、という前提は成り立ちません。
robots.txtは、クローラーへのお願いです。従うかどうかは、それぞれのクローラーの作りに任されています。特に、利用者の操作で動く取得は扱いが別だと考えてください。お願いを無視する作りのクローラーも、現実には存在します。
利用者の操作で取りに来る場合
Perplexity-Userは、robots.txtを原則として無視すると公式にあります。ChatGPT-Userにも、指定が適用されない場合があるとOpenAIは説明しています。
拒否したつもりでも、人がAIに質問したときの取得は届くのが実態です。「robots.txtに書いたのにアクセスがある」という状況は、設定の誤りとは限りません。ログを見て慌てる前に、どの名前からの取得かを確かめてください。
本当に止めたいなら、サーバー側で見る
確実に遮断したい場合は、サーバー側の設定になります。各社とも使うIPアドレスの範囲を公開しているため、それをもとに判断する形です。
ただし、手間も危険もあります。誤って通常の検索のクローラーまで遮断すると、順位そのものを失います。有料の内容など本当に守りたいものは、ログインで保護するほうが確実です。サーバーの設定は、専門の人に任せるのが無難です。
AIクローラーを拒否する前に、何を許可して何を止めるか決める
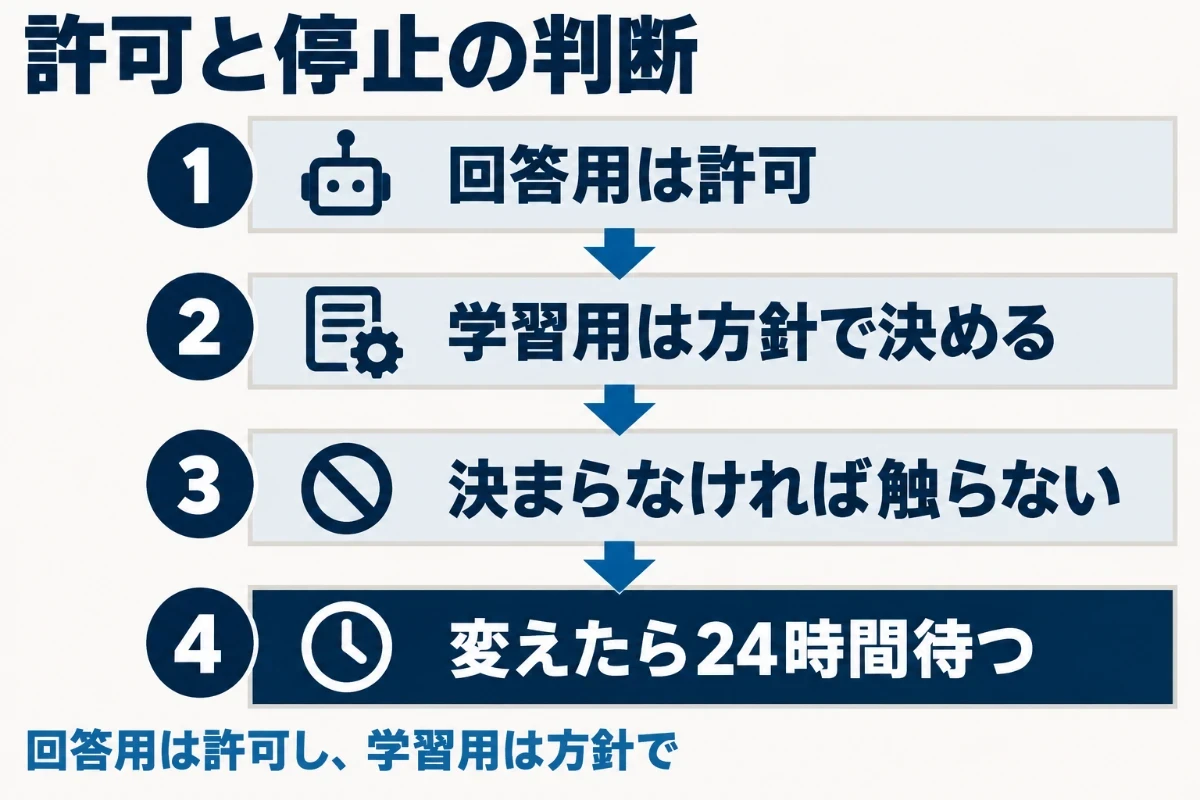
判断は、下から順に進めます。まず回答用を許可し、学習用は自社の方針で決めます。順番を逆にすると、学習を止めたつもりで回答まで閉じがちです。
方針が決まらないうちは、無理に書き換えないことも1つの判断です。何も書かなければ、既定では取得を許可した状態になります。書き換えは、方針が固まってから1回で済ませるほうが混乱しません。
集客が目的なら、回答用は許可する
問い合わせを増やすためにサイトを運営しているなら、回答用を止める理由はほとんどありません。AIからの流入を、自分から閉じることになるからです。
学習用については、判断が分かれます。記事を資産と考えるなら拒否も選べますし、名前を知ってもらう機会と考えるなら許可も選べます。どちらが正解とは言えないため、自社の考えで決めてください。
変えたら、24時間ほど待つ
robots.txtを変えても、すぐには反映されません。OpenAIとPerplexityはどちらも、反映まで24時間ほどかかると案内しています。
直後にログを見て、効いていないと判断するのは早すぎます。変えた日を記録し、数日たってからログを見直してください。変えた理由も一緒に書き残しておくと、あとで方針を見直すときに役立ちます。
当サイトの設定
当サイトは、どのAIクローラーも止めていません。robots.txtは、管理画面を除外し、サイトマップの場所を示すだけです。
記事は、AI検索から見つけてもらうために書いています。学習を拒否して露出を減らすことに、実利がないと判断したためです。学習だけを止めたくなった場合も、学習用の行を足せば済みます。
AIクローラーに関するよくある質問
GPTBotを止めると、ChatGPTに出なくなりますか
出なくなるとは限りません。GPTBotは学習用で、ChatGPTの検索に出すためのものはOAI-SearchBotです。
OpenAIは、2つが独立していると説明しています。GPTBotだけを止め、OAI-SearchBotを許可しておけば、検索の回答に出る余地は残ります。ChatGPTに出したいなら、OAI-SearchBotを止めていないかを確かめてください。
Google-Extendedを止めると、Google検索の順位は下がりますか
下がりません。Googleは、Google-Extendedが検索での登録やランキングに影響しないと明記しています。
Google-Extendedが関わるのは、Geminiの学習と回答の根拠づけへの利用です。ただし、Googlebotを止めると検索から消えるため、名前を取り違えないでください。書いたあとは、Search ConsoleのURL検査でページが読めるかを確かめておくと安心です。
すべてのAIクローラーをまとめて止める書き方はありますか
1行でまとめて止める決まった書き方はありません。名前を1つずつ書く必要があります。
「User-agent: *」で全部を止めると、通常の検索のクローラーまで止まります。AIだけを止めたいなら、止めたい名前を1つずつ並べてください。新しいクローラーが出るたびに、書き足す手間がかかる点も覚えておきます。書いた名前の一覧は、半年に1度見直してください。
止めたのに、アクセスのログに名前が残ります
設定の誤りとは限りません。利用者の操作で動く取得は、robots.txtの指定が適用されない場合があるためです。
ログの名前が、学習用、回答用、利用者の操作で動くもののどれかを確かめてください。また、変えてから24時間ほどは、前の設定のまま動くことがあります。日付を追って、変えたあとに減っているかを見ます。
llms.txtを置けば、AIクローラーを管理できますか
管理はできません。llms.txtは、AIにサイトの案内を伝えるための提案の形式で、取得を止める仕組みではありません。
取得を止めたいなら、robots.txtで名前を指定します。llms.txtを読むかどうかも、各社の判断に任されています。2つは目的が違うため、混同しないでください。robots.txtは止めるための道具、llms.txtは案内するための道具と覚えておきます。
まとめ
AIクローラーは、学習用と回答用に分かれており、robots.txtでの指定も独立しています。まとめて拒否すると、学習を止めると同時にAI検索からも消えかねません。
集客が目的なら、回答用は許可したうえで、学習用をどうするかだけを決めます。利用者の操作で動く取得には、robots.txtの指定が及ばない場合があります。変えたら24時間ほど待ち、ログで確かめてください。
まずは自社のrobots.txtを開き、昔のテンプレートの行が残っていないかを確かめてください。